
CEPH - billige Lösung für Shared Storage im PROXMOS Cluster!?
Wenn ich mir die populären Anleitungen für die Konstruktionen von PROXMOS - Clustern so anschaue, enden die in der Regel schon bei Netzwerk und Storage.
Nimmt man es genau und will seine Investition nicht "versenken", so muss man zwingend auch über ein redundantes Netzwerk und ein redundantes Storage nachdenken.
Für das Shared storage im Cluster gibt es mit der "CEPH" Technologie eine vermeintlich preiswerte Technologie.
Was ist CEPH eigentlich (und auch hier verweise ich auf meine vereinfachte Darstellung - ich möchte erreichen, dass auch Menschen außerhalb unserer "Nerd-Bubble", die aber in Ihrer Entscheidungsfindung durchaus in Kontakt mit solchen Technologien kommen, Verständnis dafür erlangen können):
Mittels CEPH werden Datensätzen so über alle Festplatten verteilt, dass sie redundant gespiegelt in verschiedenen Plattenstapeln auf den Hosts liegen. Im Falle des Ausfalls eines Knotens steht jeder Datensatz also mindesten noch einmal auf einem anderen Knoten zur Verfügung (ja, ich weiß, es gibt auch die Methode "Erasure Coding" - das Ergebnis bleibt gleich, die Voraussetzungen sind different).
Im Prinzip werden alle vorhandenen Festplatten über alle Knoten zusammengefasst und als ein großes Storage (shared storage) behandelt.
Was bedeutet das für die Performance? Bestimmt die langsamste Platte dann die Gesamtperformance und eventuelle schnelle und teure Platten haben keinen Einfluss mehr?
Ganz so ist es nicht, aber ähnlich ...
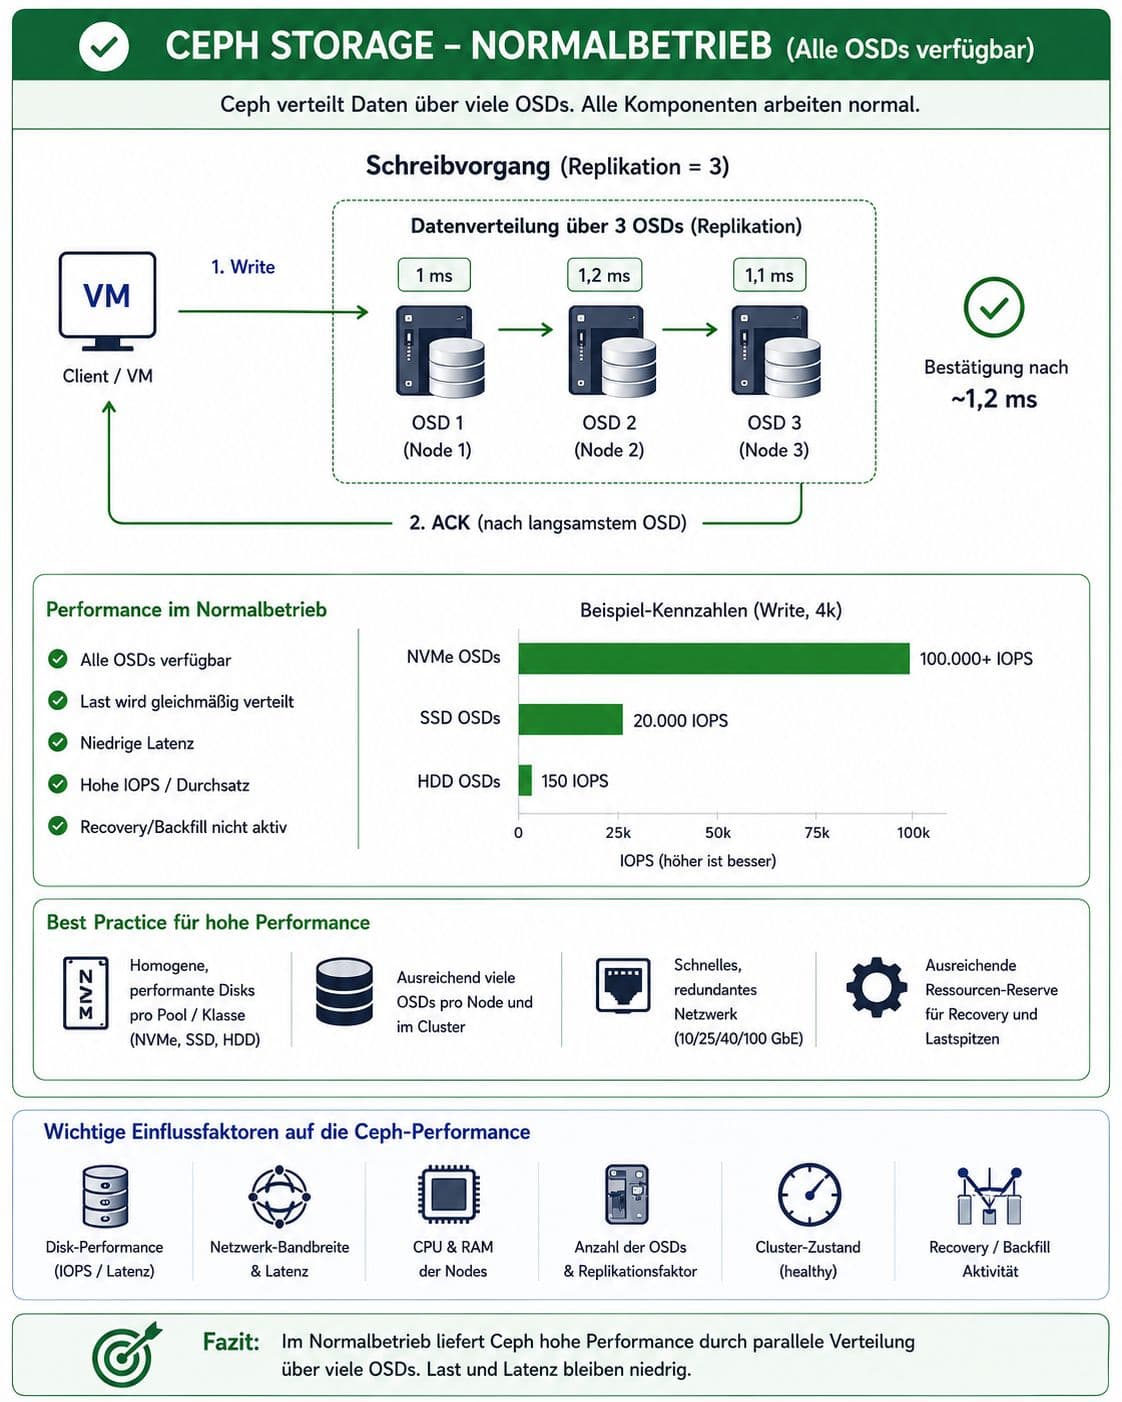
Bei CEPH bestimmt nicht nur Disk-Performance die Gesamtperformance, die Kette sieht eher so aus:
VM -> QUEMU -> Netzwerk -> Primary OSD -> weitere OSDs -> Replikation -> Quittung
("OSD" ist die grundlegende Einheit, die physische Festplatten verwaltet und Daten als Objekte zur Verfügung stellt).
Über die Entwicklung der Verfügbarkeit in derartigen seriellen Ketten habe ich bereits referiert - aber jeder kann sich vorstellen, dass das nicht unbedingt von Vorteil ist.
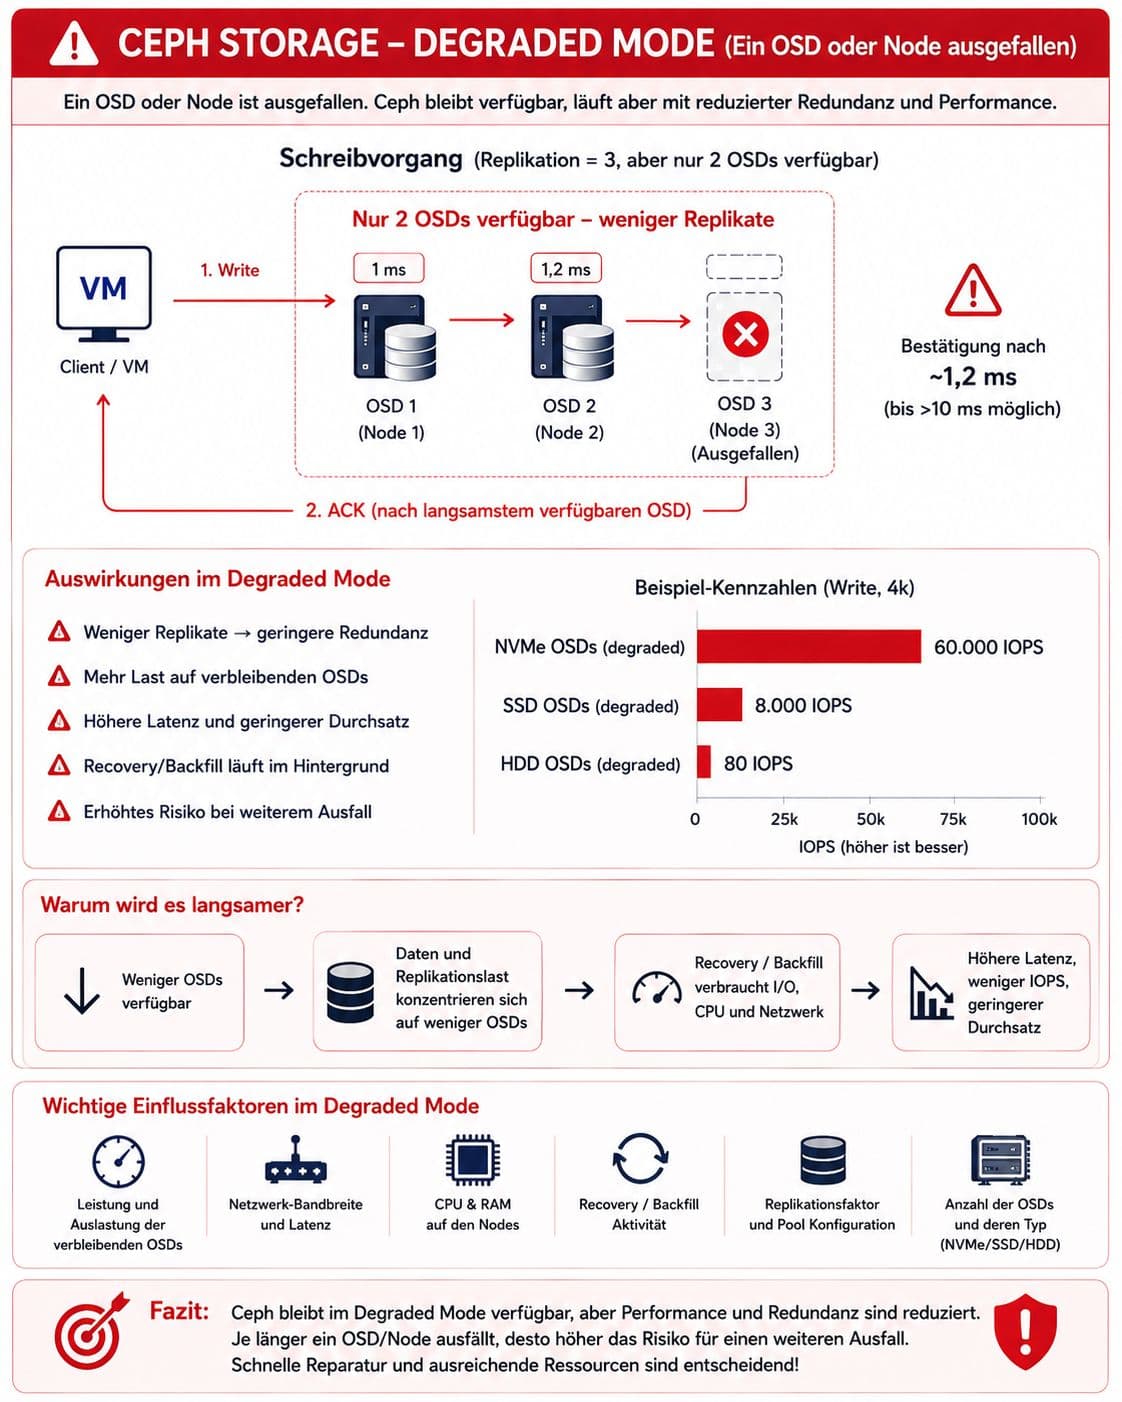
Die Performance eines CEPH-Clusters wird durch das Zusammenspiel von OSDs, Netzwerk, Replikation und Clusterzustand bestimmt. Langsame OSDs können die Latenz der betroffenen I/O-Pfade und damit die Gesamtperformance erheblich beeinflussen.
Die Performance ist im Normalbetrieb relativ gut skalierbar, problematisch wird es bei Ausfall relevanter Komponenten - da kann die Performance wirklich schnell "in den Keller" gehen. Sollte man auf dem Zettel haben.
Wir sind Experten für robuste, hochverfügbare IT-Plattformen und helfen seit mehr als 20 Jahren Unternehmen aller Größenordnungen dabei, kritische Prozesse ohne ungeplante Downtimes zu produzieren. Dich interessiert das Thema und Du möchtest wissen, wie Du Deine Prozesse gegen Ausfälle absichern kannst?
➕ folge mir und verpasse keinen Post mehr 🤝 vernetze Dich mit mir 🖥️ Lass uns reden!
Zuerst auf LinkedIn erschienen: Zum Original
Lassen Sie uns ins Gespräch kommen.
Ob IT-Ausfallsicherheit, Monitoring oder Fehlertoleranz: Wir beraten Sie persönlich und unverbindlich.
+49 30 802020990