
Drei Knoten für ein Proxmos-Cluster - Geld zum Fenster raus?
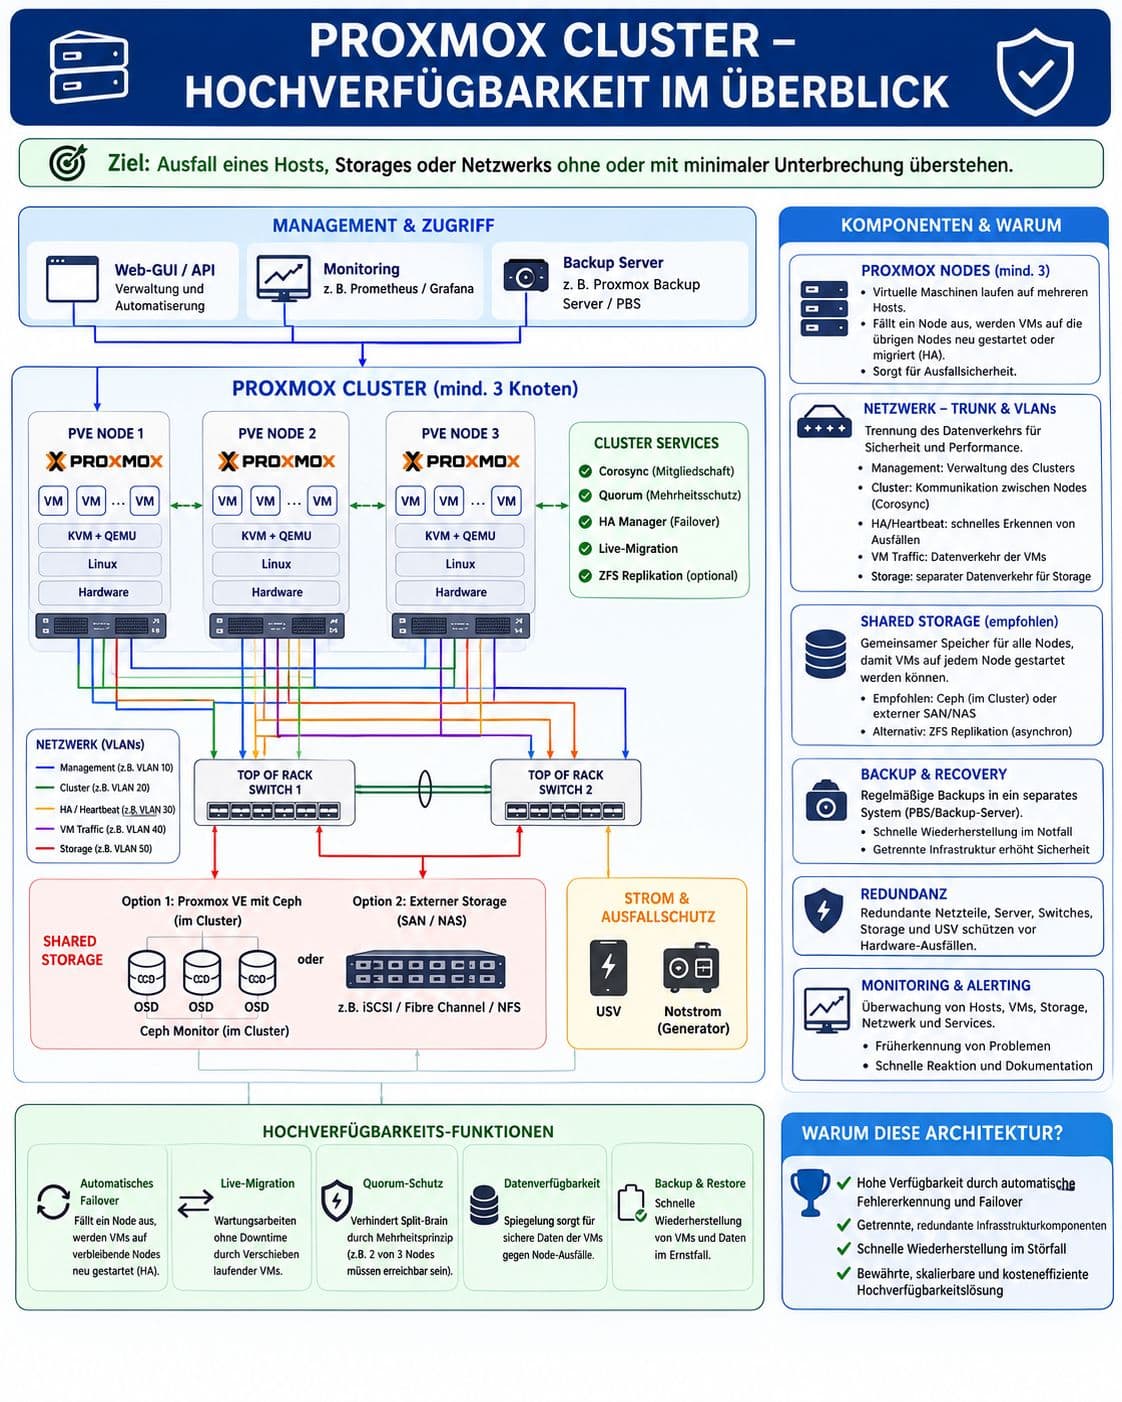
Vorweg geschickt: Ich versuche die Erklärung auf einem Niveau für Budget-Entscheider zu liefern. Diese sind oft mit solchen technischen Buzzwords und Erklärungen konfrontiert, sind allerdings nicht die Experten auf diesem Gebiet. Dennoch müssen sie auf der Basis ihrer Informationen oft weitreichende Entscheidungen treffen.
Also liebe Experten: Ich bin mir der Tatsache bewusst, dass nicht alle meine Erklärungen 100% wissenschaftlich sattelfest begründet werden - dennoch bleibt die Wirkung und Funktion davon unbeeinträchtigt.
Diverse Handbücher, Howto's, Experten, ... lassen an eine 3-Knoten-Architektur für ein Proxmos-Cluster keine Luft - wenn die ganze Konstruktion hochverfügbaren Betrieb sicherstellen soll.
Warum eigentlich? (Meines Erachtens wird die Frage nach dem "Warum" bei den Lösungsdiskussionen viel zu selten gestellt).
Hauptgrund für die (Mindest) -anzahl von 3 Knoten ist die Anforderung aus dem Quorum-Prinzip (Basis: Corosync Cluster Software). Auf den Punkt gebracht soll diese Technologie quasi den Eintritt eines Split-Brains verhindern.
Was ist Split-Brain? In diesem Kontext - vereinfacht gesagt - ein Zustand, in dem durch fehlende Kommunikation zwischen den Hosts einzelne VM's gleichzeitig auf unterschiedlichen Hosts gestartet werden können, was zu korrupten Daten führen würde.
Jetzt könnte man ja schlussfolgern, die zu rechnende Last (VM's) auf alle drei Knoten zu verteilen und damit die Hardwarekosten zu minimieren.
Das ist leider ein Irrtum. Drei Knoten lösen erstmal das Quorum-Problem - nicht das Kapazitätsproblem.
Was bedeutet das für 100 % Workload?
Nehmen wir an, deine gesamte produktive VM-Landschaft benötigt:
100 CPU-Einheiten + 100 RAM-Einheiten + 100 Storage-Performance
Dann wäre es ein Fehler, einfach zu sagen:
Node 1 = 33 % Node 2 = 33 % Node 3 = 33 %
Das funktioniert im Normalbetrieb. Fällt aber ein Node aus, stehen nur noch 66 % der benötigten Compute-Kapazität zur Verfügung. Proxmox kann die VMs des ausgefallenen Nodes zwar auf den verbleibenden Nodes neu starten, aber die Ressourcen müssen dort auch tatsächlich vorhanden sein. Genau darauf weist Proxmox bei HA-Recovery ausdrücklich hin.
Eine Empfehlung geht bei der Dimensionierung in Richtung 60-70% Last je Knoten.
Bei CEPH wird es dann noch interessanter - aber das ist ein Thema für einen nächsten Post.
Wir sind Experten für robuste, hochverfügbare IT-Plattformen und helfen seit mehr als 20 Jahren Unternehmen aller Größenordnungen dabei, kritische Prozesse ohne ungeplante Downtimes zu produzieren. Dich interessiert das Thema und Du möchtest wissen, wie Du Deine Prozesse gegen Ausfälle absichern kannst?
Zuerst auf LinkedIn erschienen: Zum Original
Lassen Sie uns ins Gespräch kommen.
Ob IT-Ausfallsicherheit, Monitoring oder Fehlertoleranz: Wir beraten Sie persönlich und unverbindlich.
+49 30 802020990